AI開発 / Tech
OpenCodeのスキルがサブエージェント呼び出さない問題
Xでシェア
ON AIR
0:00
--:--
RADIO
最近は普段のコーディングにOpenCodeを使ってます。
OpenCodeはスキル・サブエージェントのいずれにも対応しており、これらをうまく使ってソフトウェア開発が進んでいく体制を構築するのが最近の楽しみです。
そして、このスキルとサブエージェントを的確に定義して仕事が効率的に進む体制をプロジェクト内に作れる、ということが今後のソフトウェア開発者に求められるスキルにもなってくるでしょう。
サブエージェントは指示しなくても必要なタイミングで自動的に呼び出される、のは本当か?
結論から言うと、これは多分うまくいってないです。
少なくとも私の普段の環境(OpenCode)では、あまり自動的に呼び出される感じはありませんでした。
見てる感じ、こちらから特に指定しなければオーケストレーション担当がそのまま各タスクをやってるように見えます。
スキル内で実行するサブエージェントを指定する
じゃあどうするのって話ですが、スキル内でサブエージェントを指定したら、的確にサブエージェントに割り振るようになりました。
例えば、新機能追加スキルの冒頭はこんな感じ
---
name: feature-implementation
description: 機能追加・機能修正の全工程を定義する。背景整理から設計まではオーケストレータが直接行い、実装はチケットに分割してタスクエージェントへ委譲する。全体チェック・コードレビュー・セキュリティチェック・コミット・PR作成までをカバーする。
---

機能追加・機能修正の依頼を受けた場合、このスキルの手順に従うこと。

本スキルが実行されたら、定義済みのサブエージェントを積極的に使うこと。
特に
* 設計: solution-architect
* コードレビュー: code-reviewer
* データベースレビュー : database-reviewer
* ドキュメント更新 : documentation-manager
* Railsコーディング : rails-implementer
* フロントエンドコーディング : frontend-implementer
* セキュリティレビュー : security-auditor
* テスト : test-engineer
* git, github 操作 : repository-operator

の使用を推奨する。
他のエージェントについても必要に応じて起動して作業を進めてください。
各サブエージェントが使用するLLMモデルについては、各サブエージェントで定義されているモデルを使用すること。


**各フェーズにおいて、依頼内容・要件・設計の意図などで不明瞭な点があれば、その時点でユーザーに質問し、明確にしてから次に進むこと。** 推測で進めると手戻りが発生するため、不明点は必ず確認する。

(中略)

```
背景・目的の明確化
  ↓
理想と現実の検討 → 最終案の決定
  ↓
要件の洗い出し
  ↓
現状調査(コード・ライブラリ・既存UI/UX)
  ↓
設計方針(設計サブエージェントに依頼) → インターフェイス設計(設計サブエージェントに依頼) → 内部設計(設計サブエージェントに依頼) → DB設計(設計サブエージェントに依頼)
  ↓
チケット分割・実行計画の作成(設計サブエージェントに依頼)
  ↓
ブランチ作成(レポジトリ・サブエージェントに依頼)
  ↓
タスクエージェントへ委譲(依存関係に基づき並列/直列を制御)
  ↓  各エージェント内の小ループ:(すべてRails実装サブエージェント、ビジュアルビューサブエージェントに依頼)
  ↓  実装 → 静的解析 → 関連テスト → セルフレビュー → 動作確認 ↺
  ↓
完了報告の検収(全チケット)
  ↓
全体チェック: 型チェック → Rubocop → セキュリティスキャン → 全テスト
  → システムテスト → コードレビュー(コードレビューサブエージェントに依頼) → 機密情報スキャン → セキュリティレビュー(セキュリティレビューサブエージェントに依頼)
  ↓  問題があれば修正チケットを起票して委譲へ戻る(大ループ)
要件充足の確認
  ↓  未充足ならチケットを起票して委譲へ戻る(大ループ)
コミット → プッシュ → PR作成 → 報告(レポジトリサブエージェントに依頼)
```
(以下略)
良い感じに勝手に判断してくれると嬉しいんだけど、とりあえず今はこれでやってます。
実際にはこんな感じになる。
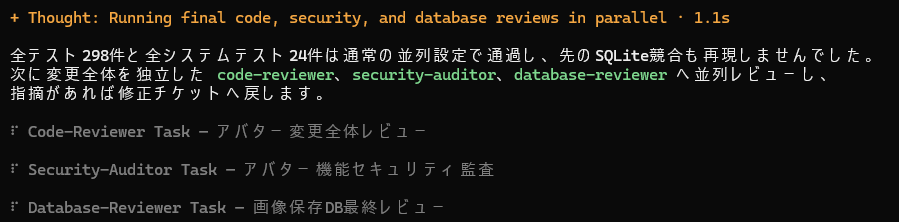
上記の設定をしてから、各レビュワーがサブエージェントで並列実行されるようになりました。
コストとか
私は各エージェントのに使用するモデルを、サブエージェントごとの担当区域によって分けています。
シンプルに
- 設計とかレビューは
GPT 5.6 Sol - ドキュメント整備は
GPT 5.6 Terra - 実装は
DeepSeekV4 flash
てな感じです。
入り(設計)と出(レビュー)を高い知能を持つモデルでしっかりやり、その中のタスク作業はDeepSeekV4など安価で速いモデルにやらせてます。
こんな感じにするとCodexでGPTだけ使ってやるより時間の節約、お金の節約になるのでは、という狙いですね。
こういうことができるのはOpenCodeみたいに色々なモデルが扱えるツールの強みだと思います。
コメント
まだコメントはありません。